2026. 9. 19. 20:43ㆍ카테고리 없음
데이터 수집 계층 · 옵션 시장
CBOE 데이터는 왜 두 파일에 나뉘어 있나
출처가 같아도 깨지는 방식이 다르면 같이 두지 않는다 — 스크래핑 1개와 시세 API 5개의 분리
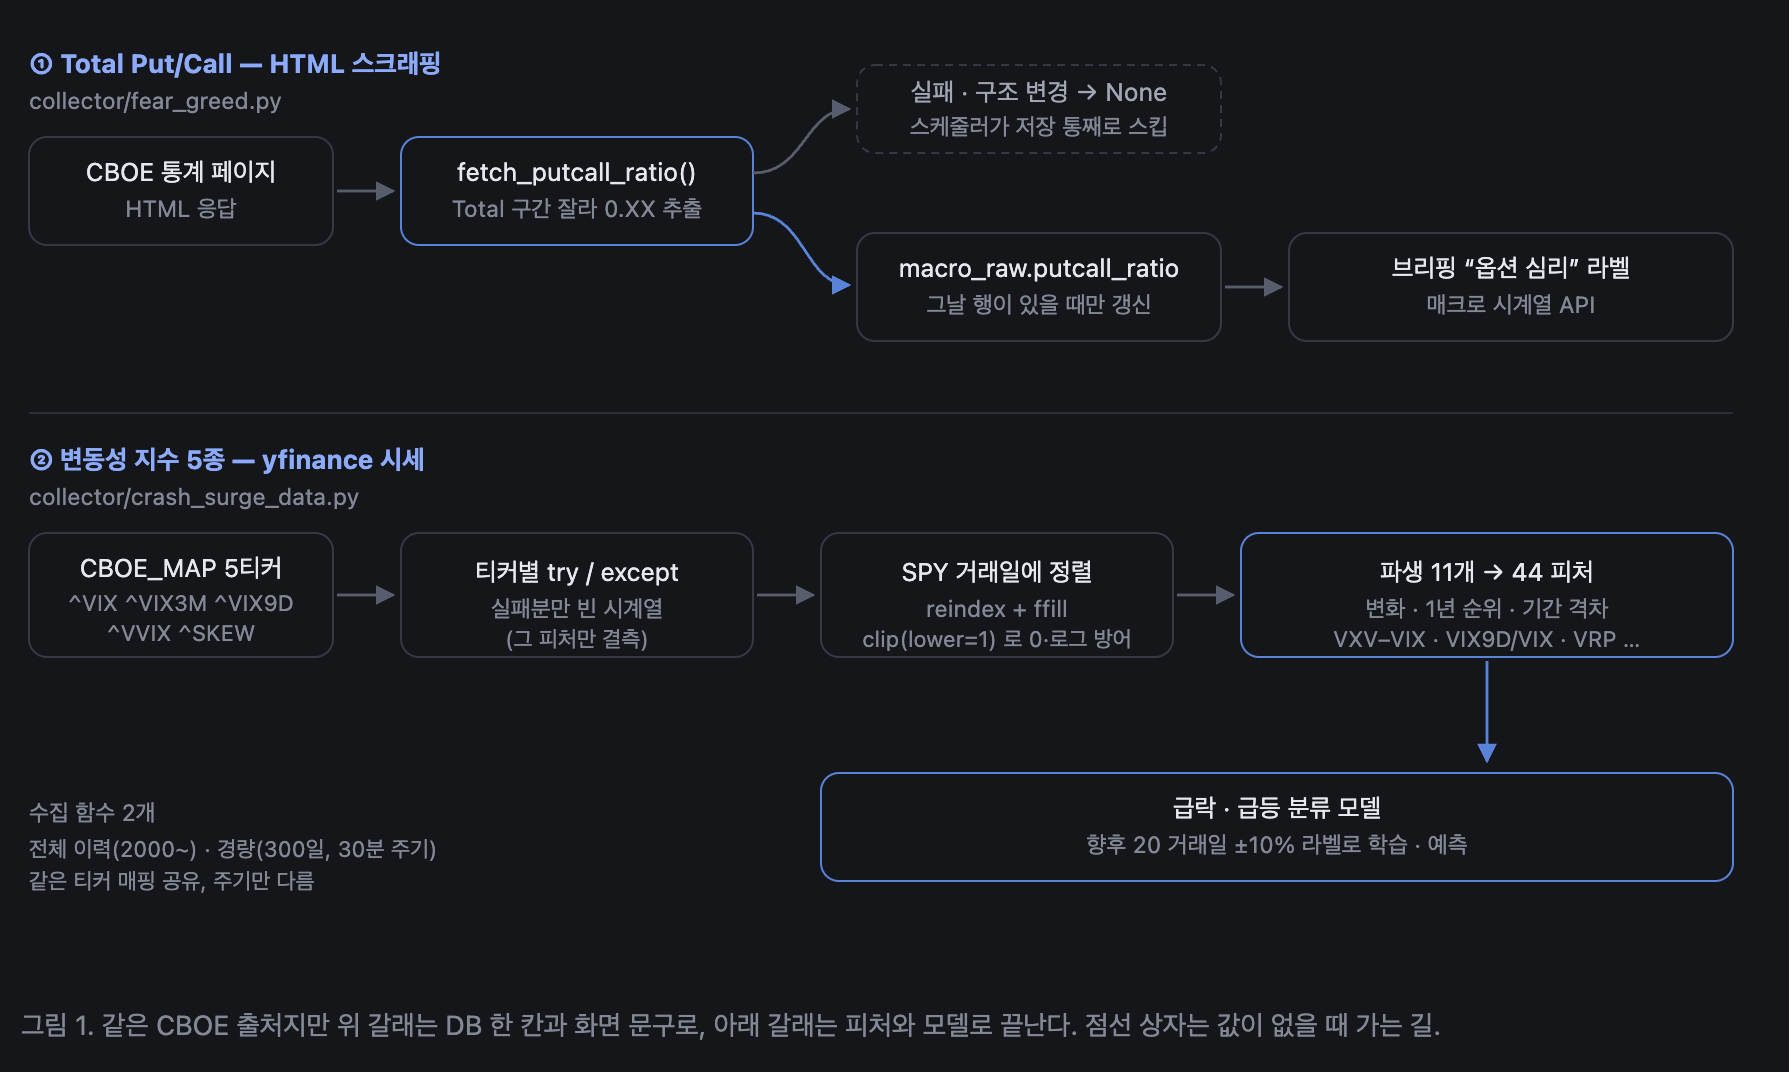
시카고옵션거래소(CBOE)에서 오는 값은 이 프로젝트에 두 갈래로 들어옵니다. 하나는 Total Put/Call 비율, 하나는 변동성 지수 5종(VIX · VIX3M · VIX9D · VVIX · SKEW)입니다. 출처는 같지만 같은 파일에 있지 않습니다. 들어오는 경로가 다르고, 깨지는 방식이 다르고, 쓰이는 곳이 다르기 때문입니다.
| 무엇 | 경로 | 최종 소비처 | 파일 |
| Total Put/Call 비율 | HTML 스크래핑 | 마켓 브리핑 "옵션 심리" · 매크로 시계열 | collector/fear_greed.py |
| VIX · VIX3M · VIX9D · VVIX · SKEW | yfinance 시세 | 급락·급등 예측 모델 입력 44개 중 11개 | collector/crash_surge_data.py |
표 1. "HTML 구조가 바뀌면 깨진다"는 위험은 위쪽 한 줄에만 해당한다.
1. Put/Call 이 공포·탐욕 파일에 사는 이유
파일 이름만 보면 어색합니다. 공포·탐욕 지수는 CNN이 주고 Put/Call은 CBOE가 줍니다. 그런데도 한 파일에 있는 건 출처가 아니라 성격이 같아서입니다. 둘 다 하루 한 번 갱신되는 심리 지표 스칼라 하나이고, 둘 다 공식 API가 없어 남의 웹 응답을 긁어옵니다. 그래서 봇 차단을 피하는 수단도 같습니다 — 두 함수 모두 curl_cffi 로 크롬 TLS 지문을 흉내 낸 세션을 씁니다. 같은 이유로 같이 깨질 코드는 같이 두는 편이 고치기 쉽습니다.
파싱은 일부러 단순합니다. HTML 파서를 붙이는 대신 제목 위치 두 개를 찾아 그 사이만 잘라 냅니다.
# Total 섹션 시작과 Index 섹션 시작을 찾아 그 사이만 남긴다.
h3_total = html.find('<h3>Total</h3>')
h3_index = html.find('<h3>Index Options</h3>')
# Total 이 없으면 페이지 구조가 바뀐 것 — 억지로 찾지 않고 항복한다.
if h3_total < 0:
    return None
total_section = html[h3_total:h3_index if h3_index > h3_total else len(html)]
# 0.XX 꼴만 걷어 마지막(가장 최근 시각) 값을 쓴다. 빈 칸은 자연히 걸러진다.
ratios = re.findall(r'<td>\s*(\d\.\d{2})\s*</td>', total_section)
중요한 건 정규식이 아니라 실패했을 때의 태도입니다. Total 섹션이 없으면 다른 섹션에서 비슷한 숫자를 주워 오지 않고 None 을 돌려줍니다. 스크래핑에서 제일 위험한 실패는 예외가 아니라 엉뚱한 값이 조용히 들어오는 것입니다. Index 옵션 비율을 Total로 착각해 저장하면 아무도 에러를 보지 못하고, 그 숫자는 그대로 화면에 심리 지표로 뜹니다. 그래서 네트워크 실패·구조 변경·파싱 실패가 전부 같은 결말로 모입니다.
2. 저장은 덮어쓰기가 아니라 '있는 행만 채우기'
스케줄러는 하루 배치의 4단계에서 공포·탐욕을 받아 저장하고, 이어서 Put/Call을 받습니다. 값이 None 이면 저장 단계를 통째로 건너뜁니다. 값이 있으면 그날 날짜의 매크로 원본 행에 컬럼 하나만 얹습니다.
이 부분 갱신에는 patch_only 라는 조건이 붙어 있습니다. 그 날짜 행이 이미 있을 때만 갱신하고, 없으면 만들지 않고 건너뜁니다. 예전에 이 조건 없이 upsert를 하다 사고가 있었습니다 — Put/Call만 들어간 행이 먼저 생기면서 VIX·금리 같은 핵심 컬럼이 전부 비어 있는 행이 만들어졌고, 데이터 현황 대시보드가 그 빈 행을 보고 수집이 밀린 것으로 잡았습니다. 부분 갱신은 본 수집이 행을 만든 뒤에만 의미가 있습니다.
저장된 값은 두 곳에서 읽힙니다. 마켓 브리핑은 숫자를 그대로 보여주지 않고 구간 라벨로 바꿉니다 — 1.1 이상이면 하락 대비 우세, 0.9 이하면 상승 기대 우세, 사이는 중립. 매크로 라우터는 같은 컬럼을 vix·yield_spread 등과 묶어 시계열로 내보냅니다.
3. 변동성 지수 5종 — 수집보다 손질이 본체
VIX 계열은 티커 매핑 한 줄에서 시작합니다. ^VIX · ^VIX3M · ^VIX9D · ^VVIX · ^SKEW. HTML을 보지 않으니 CBOE가 페이지를 리뉴얼해도 무관합니다. 이 파일의 진짜 일은 모델이 먹을 형태로 바꾸는 것이고, 티커 5개가 44개 피처 중 11개를 만듭니다.
| 피처 | 무엇을 재나 |
| VIX_LEVEL · VIX_CHANGE_1D · VIX_CHG_5D | 수준(로그)과 1일·5일 변화. "높다"와 "빠르게 올랐다"를 분리 |
| VIX_PCTL_252D | 최근 1년 안에서의 순위. 절대값이 아니라 상대 위치 |
| VXV_MINUS_VIX · VIX_VIX3M_RATIO | 3개월 대 1개월. 음수로 뒤집히면 단기 공포가 장기를 추월 |
| VIX9D_MINUS_VIX · VIX9D_VIX_RATIO | 9일 대 30일. 더 짧은 구간의 긴장 |
| VVIX_LEVEL · SKEW_LEVEL | 공포 자체의 불안정도 · 급락 보험료(꼬리 위험) |
| VARIANCE_RISK_PREMIUM | 시장이 예상한 변동성과 실제로 일어난 변동성의 차 |
표 2. 지수를 그대로 쓰는 건 둘뿐이고, 나머지는 기간 간 격차·변화·순위로 바뀐다.
시간축은 SPY 거래일 하나로 고정합니다. 모든 지수를 SPY 인덱스에 재배열하고 빈 날은 직전 값으로 채웁니다. 기준 달력을 하나로 두면 지수마다 다른 휴장일을 매번 따로 맞출 필요가 없습니다. 나눗셈과 로그에는 하한이 걸려 있어(clip(lower=1)) 0이나 음수가 들어와도 무한대·NaN이 피처로 새지 않습니다.
4. 하나가 실패해도 나머지는 산다
다섯 개는 반복문으로 받되 실패는 그 하나에만 갇힙니다. 못 받은 지수는 빈 시계열로 채워 넣고 넘어가고, 뒤쪽 계산은 "키가 없다"로 터지는 대신 그 피처만 결측으로 남깁니다. VVIX 하나 때문에 예측 파이프라인 전체가 멈추는 것보다 낫다는 판단입니다. 같은 태도가 앞 단계에도 있습니다 — SPY 시세는 3번 재시도하고 그래도 안 되면 다른 공급처로 갈아타고, 그마저 실패할 때만 예외를 던집니다.
수집 함수는 둘입니다. 전체 이력(2000년~)을 받는 무거운 쪽과, 최근 300일만 받는 가벼운 쪽. 둘은 같은 티커 매핑을 공유하고 부르는 주기만 다릅니다 — 하루 한 번 이력을 다시 만드는 일과, 30분마다 마지막 점을 갱신하는 일은 비용이 다르기 때문입니다. 가벼운 쪽은 장중 호출이면 실시간 가격이 그대로 섞입니다.
5. 전체 흐름
6. 이 구조가 남긴 것
얻은 것은 고장 범위가 좁다는 점입니다. CBOE가 페이지를 바꾸면 Put/Call 한 칸이 비지만 모델 입력은 멀쩡하고, 시세 공급처가 흔들리면 그 반대가 됩니다. 두 수집을 한 파일에 묶었다면 "CBOE 수집 실패"라는 하나의 큰 고장이 됐을 겁니다.
치른 값도 있습니다. 파일 이름만으로는 Put/Call이 어디 있는지 알 수 없고(공포·탐욕 파일 안에 있으니까요), 스크래핑 쪽은 언젠가 반드시 깨집니다. 지금 구조는 그걸 막는 게 아니라, 깨졌을 때 틀린 값이 조용히 들어오지 않게 막을 뿐입니다.
정리
- 출처가 같아도 깨지는 방식이 다르면 나눈다 — 스크래핑과 시세 API는 고장 원인이 겹치지 않는다.
- 묶는 기준은 출처가 아니라 갱신 주기와 실패 방식 — Put/Call이 공포·탐욕과 한 파일에 있는 이유.
- 스크래핑의 진짜 위험은 예외가 아니라 조용히 틀린 값 — 확신 없으면 값을 만들지 말고 None을 낸다.
- 보조 지표는 빈 칸을 만들지 않는다 — 본 수집이 만든 행에만 컬럼을 얹어야 현황이 오탐하지 않는다.
- 부분 실패는 그 항목만 결측으로 — 지수 하나에 파이프라인 전체가 걸리지 않게.
- 시간축은 기준 달력 하나, 나눗셈·로그에는 하한 — NaN·무한대는 피처 단계에서 막는다.
collector/fear_greed.py · collector/crash_surge_data.py · scheduler/job.py · database/repositories.py 기준 · 코드 인용은 실제 수집 계층에서 발췌