2026. 10. 8. 20:41ㆍ카테고리 없음
화면 뒤의 데이터 판단 · LLM 계층
processor/llm_gate.py — 무료 LLM 네 곳을 한 줄로 세우는 법
7월에 적어 둔 아키텍처 설명과 지금 코드를 나란히 놓고 읽은 기록
Passive 의 아키텍처 문서(.omm/data-flow/llm)에는 2026년 7월 22일에 적은 설명이 있습니다. "Cerebras·Groq·Gemini 로 시황 리포트를 만들고, FinBERT 로 뉴스 감성을, TimesFM·GRU 로 경로를 예측한다. 로컬에서는 LLM 을 막고 캐시만 읽는다." 두 달 반이 지난 지금 코드로 내려가 보면, 맞는 문장도 있고 이미 달라진 문장도 있습니다.
1. provider 는 하나가 아니라 줄이다
설명에는 provider 세 곳이 나란히 적혀 있지만, 실제로는 앞에서부터 차례로 두드리는 폴백 줄입니다. processor/analyst_outlook.py 의 _gemini_json 이 그 줄을 만듭니다. 이름은 Gemini 지만 Gemini 는 기본으로 빠져 있습니다.
| 순서 | provider · 이 자리에 있는 이유 |
| (0차) | Gemini — allow_gemini=True 인 호출(AI 종합판단 본문)만. 무료 티어가 모델별 하루 20회라 아껴 쓴다. |
| 1차 | NVIDIA NIM — 2026-08-28 에 1차로 올라옴. Cerebras 무료분이 소진돼 402 를 돌려주고 있었다. |
| 2차 | OpenRouter — 7월 설명에는 없던 provider. |
| 3차 · 4차 | Cerebras → Groq — 설명에선 맨 앞이던 Cerebras 가 뒤로 밀렸다. |
| 전부 실패 | None 반환 → 호출자가 규칙 기반 문장으로 폴백. |
표 1. processor/analyst_outlook.py _gemini_json 의 호출 순서와 docstring 에 적힌 사유.
# processor/analyst_outlook.py · _gemini_json (line 489~503)
# 이번 호출에서 시도할 provider 함수를 순서대로 담을 빈 줄을 만든다
    calls = []
# AI 종합판단처럼 Gemini 를 허락받은 호출일 때만 Gemini 를 맨 앞에 세운다
    if allow_gemini:
        # 따로 지정한 모델이 있으면 그 모델을 먼저 시도한다
        if model and model != _GEMINI_MODEL:
            # 지정 모델 호출을 줄에 넣는다
            calls.append(lambda: _gemini_call(prompt, max_out, temp, model=model))
        # 기본 flash 모델을 그 다음 순서로 넣는다
        calls.append(lambda: _gemini_call(prompt, max_out, temp))
    # 나머지 호출은 모두 NVIDIA → OpenRouter → Cerebras → Groq 순으로 줄을 선다
    calls += [lambda: _nvidia_json(prompt, max_out, temp),
              # 2차: OpenRouter
              lambda: _openrouter_json(prompt, max_out, temp),
              # 3차: Cerebras
              lambda: _cerebras_json(prompt, max_out, temp),
              # 4차: Groq
              lambda: _groq_json(prompt, max_out, temp)]
    # 줄 앞에서부터 하나씩 실제로 호출한다
    for fn in calls:
        # 이 provider 의 응답 텍스트를 받는다(실패면 빈 값)
        txt = fn()
        # 텍스트가 왔으면 거기서 멈춘다
        if txt:
            # 첫 성공 텍스트를 그대로 돌려준다
            return txt
    # 네 곳이 모두 실패하면 None — 호출자가 규칙 문장으로 대신한다
    return None
2. 줄 앞의 문지기 — llm_gate.py
줄을 세우는 것만으로는 부족했습니다. NVIDIA 를 부르는 곳이 analyst_outlook.py 와 market_brief.py 두 군데인데 같은 한도를 나눠 씁니다. 그래서 상태를 공용 게이트 processor/llm_gate.py 한 곳에 둡니다(세 파일에 흩어져 있던 로컬 차단 한 줄도 2026-08-31 에 이리로 합쳤습니다). 게이트가 하는 일은 세 가지입니다.
- 로컬 차단 — local_llm_blocked() 는 APP_ENV=local 이면 True. 로컬 개발이 prod 와 공유하는 무료 한도를 쓰지 않게 한다. 7월 설명의 마지막 문장은 지금도 그대로 맞다.
- NVIDIA 슬롯 1개 — 응답이 약 53초라 동시에 몰리면 429 가 나고 나머지는 60초 타임아웃으로 죽는다. Semaphore(1) 로 한 번에 하나만 보내고, 90초 안에 슬롯을 못 얻으면 다음 provider 로 넘긴다.
- 쿨다운 15분 — mark_dead() 는 402·429 에만 건다. 타임아웃에는 걸지 않는다 — 한도가 아니라 줄이 밀린 결과라, 걸면 멀쩡한 provider 를 통째로 끄게 된다.
사용자 요청 경로는 따로 다룹니다. 캐시가 비면 market_brief 가 요청 중에 직접 LLM 을 부르는데, 거기서 남의 배치 뒤에 줄을 서면 응답이 대기 시간에 HTTP 타임아웃까지 더해 길어집니다. 그래서 no_wait() 블록 안에서는 슬롯 대기를 0초로 바꿔, 비어 있을 때만 쓰고 아니면 건너뜁니다.
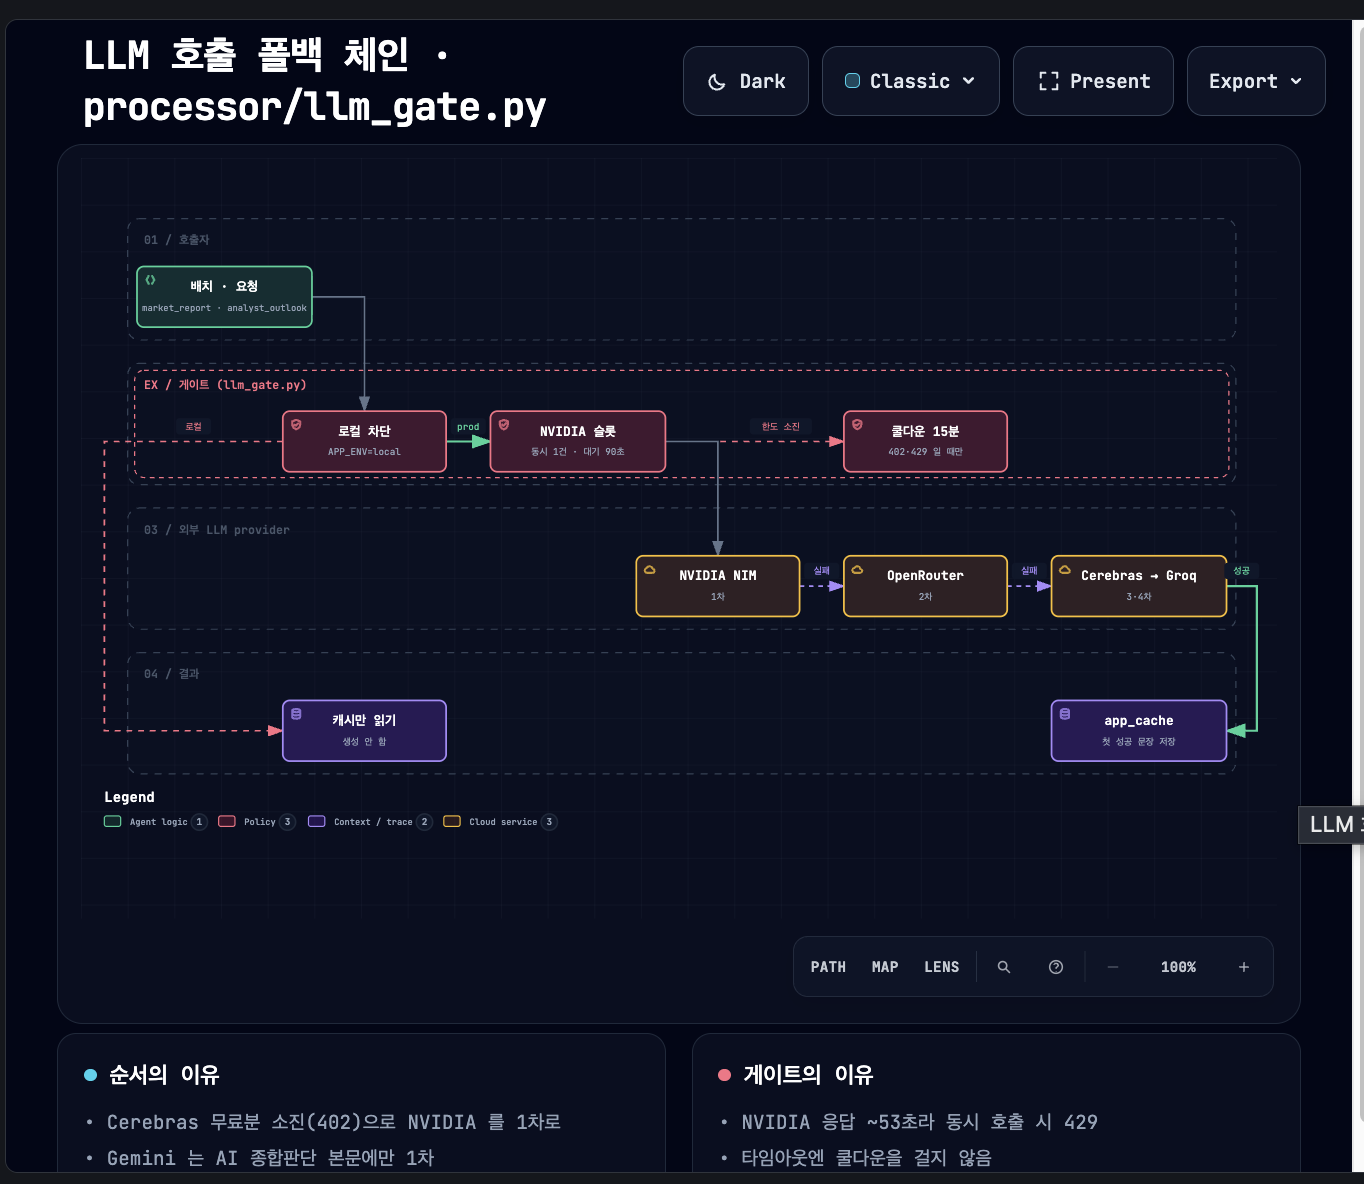
그림 1. 호출자 → 로컬 차단 → NVIDIA 슬롯 → provider 줄 → app_cache. 한도 소진(402·429)만 쿨다운으로 빠진다.
3. 설명에서 이미 낡은 문장
- FinBERT — 여전히 market_brief.py 가 불러 뉴스 감성에 쓴다. 맞는 문장.
- TimesFM · GRU — timesfm_path.py · us_gru_path.py 는 남아 있지만 scheduler/ · api/ 에서 import 하는 곳이 없다. 참조는 백필·검증 스크립트와 폐기된 폴백 chronos_path.py 뿐이다. 지금 화면의 경로 예측은 ts_path_model.py(한국) · drift_path.py(미국)가 만든다.
- "Cerebras·Groq·Gemini" — provider 목록은 NVIDIA·OpenRouter 가 더해졌고, 순서는 한도 사정에 따라 두 번 바뀌었다.
정리
- 무료 LLM 여러 곳은 나란히 쓰는 게 아니라 줄을 세운다. 줄의 순서는 그때그때 남은 한도가 정한다.
- 같은 한도를 나눠 쓰는 호출부가 둘 이상이면 상태를 한 모듈에 모은다. 그래야 슬롯과 쿨다운이 의미를 갖는다.
- 아키텍처 설명은 적은 날의 사진이다. import 한 줄로 실제 경로를 확인하기 전까지는 사실로 옮기지 않는다.
근거: processor/llm_gate.py · processor/analyst_outlook.py (_llm_ready, _gemini_json) · .omm/data-flow/llm/description.md(2026-07-22). 투자 권유가 아닙니다.
AI 시황 해설을 직접 보는 곳 → dinsightlab.com
Passive
미국 지수 투자자를 위한 금융 데이터 분석 사이트
dinsightlab.com