2026. 10. 12. 19:09ㆍ카테고리 없음
화면 뒤의 데이터 판단 · 뉴스 소스
processor/market_brief.py — 뉴스 RSS 를 두 갈래로 나누는 이유
같은 기사 묶음을 AI 브리핑용과 화면 카드용으로 따로 고르는 법
Passive 의 아키텍처 문서(.omm/data-flow/news-src)에는 2026년 7월 22일에 적은 설명이 있습니다. "Google News·연합뉴스·매경·인포맥스·머니투데이·한경·이데일리·서울경제·파이낸셜뉴스 RSS 를 collector/stock 뉴스 수집기가 모아 FinBERT 감성분석과 헤드라인 생성에 공급한다." 언론사 목록은 맞습니다. 그런데 코드로 내려가 보면 collector/stock 이라는 수집기는 없고, RSS 는 브리핑을 만드는 processor/market_brief.py 가 직접 모읍니다.
1. 소스는 성격이 다른 두 종류다
적용 화면 — 미디어 탭 › 뉴스(AI 뉴스 브리핑·오늘의 뉴스 TOP·기사 카드), 시장 리포트, 브리핑 푸시 알림. 한국 언론사 목록은 종목별 AI 요약 배치(processor/stock_ai_brief.py)도 그대로 가져다 씁니다.
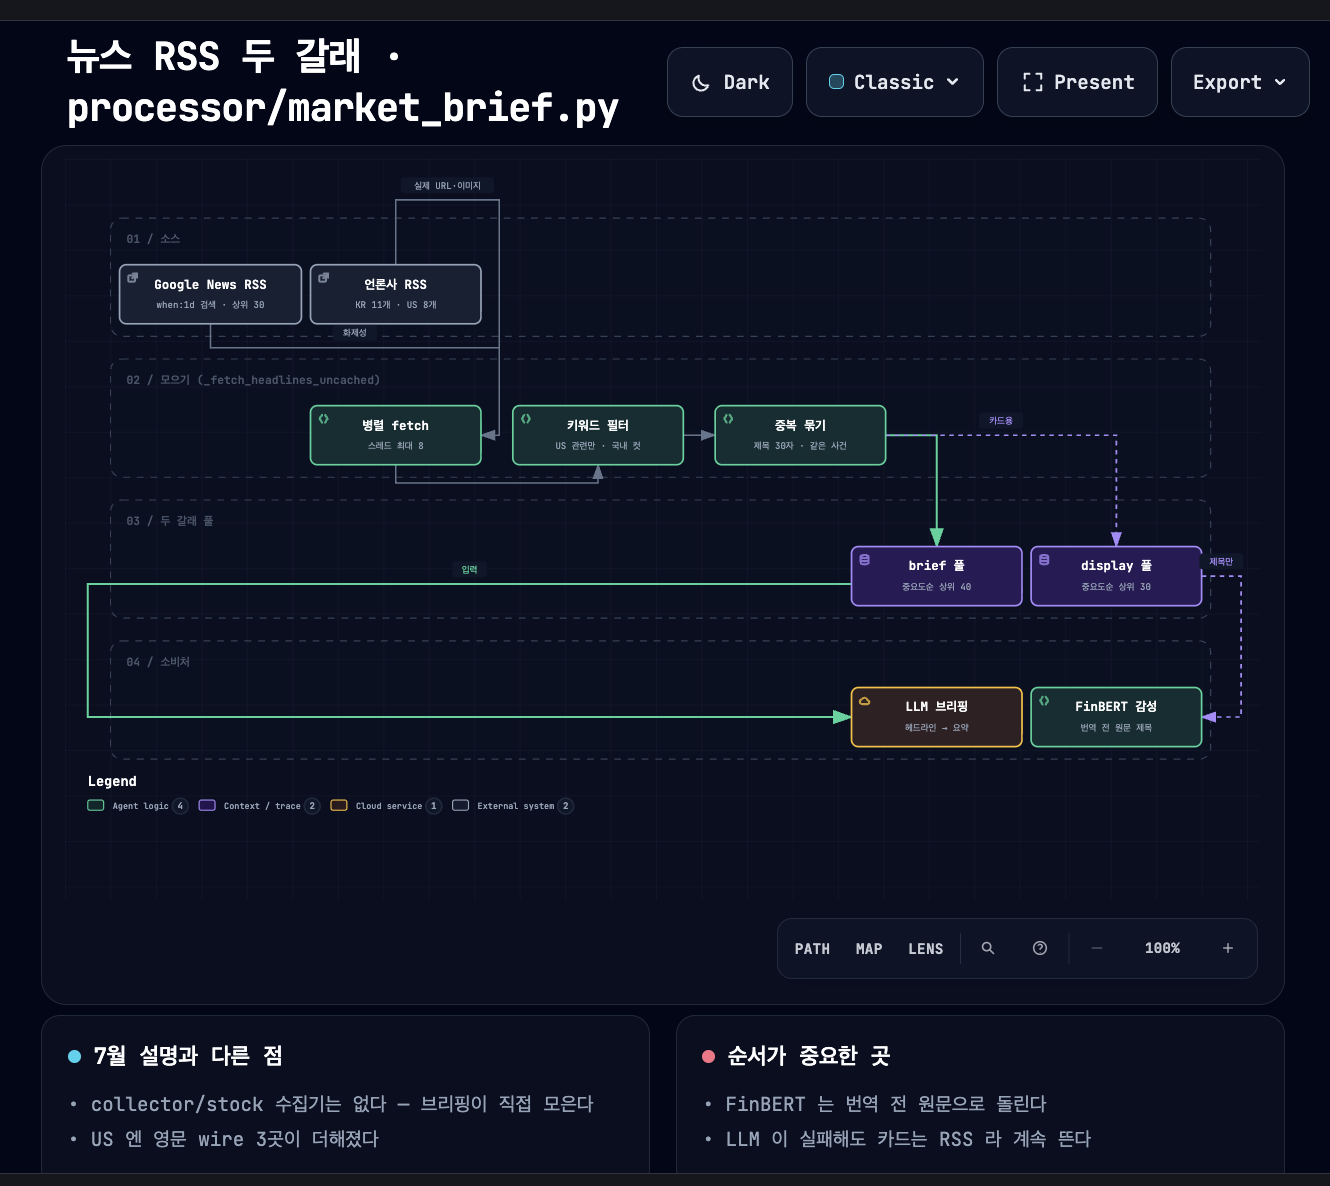
RSS 주소는 _RSS_SOURCES 와 _GNEWS_SOURCES 두 상수에 들어 있습니다. 둘은 역할이 다릅니다. Google News 는 관련도·최신성으로 순위를 매긴 검색 결과라 지금 화제인 기사를 잘 잡습니다. 언론사 RSS 는 실제 기사 주소와 이미지를 갖고 있어 화면 카드에 쓰기 좋습니다.
| 갈래 | 소스 |
| Google News | 최근 1일(when:1d) 검색. 한국은 코스피·반도체·환율 등, 미국은 뉴욕증시·연준·대형주 등을 OR 로 묶은 한국어 쿼리. 상위 30건. |
| 언론사 RSS (한국) | 11개 — 매경·한경·이데일리·서울경제·파이낸셜뉴스·머니투데이 증권면, 연합뉴스 경제, 연합인포맥스, 그리고 신선도 보강용 "전체" 피드 3개(연합·머니투데이·매경). |
| 언론사 RSS (미국) | 8개 — 한국어 5개(인포맥스·연합 국제·연합 경제·매경 세계·매경 경제) + 영문 wire 3개(MarketWatch·CNBC·Yahoo Finance). 영문은 7월 설명에 없던 소스로, 미국 정규장이 열리는 한국 밤 시간대의 기사 공백을 메운다. |
표 1. processor/market_brief.py line 22~91 의 소스 상수.
2. 거르기 — 넓게 받고 키워드로 자른다
적용 화면 — 미디어 탭 › 뉴스의 한국·미국 탭 기사 카드. 여기서 살아남은 기사만 AI 뉴스 브리핑·오늘의 뉴스 TOP·시장 리포트·푸시 알림의 재료가 됩니다.
_fetch_headlines_uncached 는 모든 피드를 스레드 최대 8개로 한 번에 받아 옵니다. 하나씩 받으면 약 1.8초가 쌓이던 것을 가장 느린 피드 하나 수준으로 줄인 것입니다. 받은 뒤에는 피드마다 25건까지만 보고, 탭마다 다른 기준으로 거릅니다.
# processor/market_brief.py · _fetch_headlines_uncached (line 393~408)
# 운세·연예까지 섞여 오는 "전체" 피드 3개의 이름을 따로 표시해 둔다
    _KR_BROAD = {'연합뉴스 전체', '머니투데이 전체', '매경 전체'}
# 언론사 피드를 하나씩 돌면서
    for source_name, url in _rss_list:
        # 그 피드에서 받은 기사 중 앞 25건만 본다
        for entry in (_feeds.get(url) or [])[:25]:
            # 제목·링크·출처·요약·이미지·시각을 담은 기사 한 건을 만든다
            it = _mk(entry['title'], entry['link'], source_name, entry)
            # 제목이나 링크가 비어 만들지 못했으면
            if not it:
                # 버린다
                continue
            # 미국 탭인데 제목에 나스닥·연준·엔비디아 같은 미국 키워드가 없으면
            if region == 'us' and not _US_FILTER.search(it['title']):
                # 버린다
                continue
            # 미국 탭인데 제목에 코스피·삼성전자 같은 국내 증시 단어가 있으면
            if region == 'us' and _US_KR_EXCLUDE.search(it['title']):
                # 버린다 (엔비디아 키워드로 들어온 국내 기사 2차 컷)
                continue
            # 한국 탭의 "전체" 피드 기사인데 증시·환율·금리 같은 시장 단어가 없으면
            if region == 'kr' and source_name in _KR_BROAD and not _KR_MARKET_KEYWORDS.search(it['title']):
                # 버린다
                continue
            # 살아남은 기사를 언론사 기사 목록에 담는다
            pub_items.append(it)
3. 같은 재료, 두 개의 풀
적용 화면 — brief 풀은 미디어 탭 › 뉴스 맨 위 "AI 뉴스 브리핑" 문장과 시장 리포트의 뉴스 근거로, display 풀은 그 아래 기사 카드 목록으로 갑니다.
걸러진 기사는 두 갈래로 나뉩니다. 순서만 다를 뿐 둘 다 Google News 와 언론사 기사를 합칩니다.
- brief 풀 — Google News 를 앞에 두고 합친다. 화제성이 먼저라 AI 브리핑의 입력이 된다. 중요도순 상위 40건.
- display 풀 — 언론사 기사를 앞에 두고 합친다. 실제 주소와 이미지가 있는 쪽이 먼저라 화면 카드가 된다. 상위 30건.
- 공통 — 제목 앞 30자가 같으면 중복으로 보고, _cluster_news 가 같은 사건을 대표 1건으로 묶으면서 몇 곳이 함께 다뤘는지 센다. 그 매체 수와 시장 키워드가 정렬 재료다.
2026-05-29 전까지는 한국 탭 카드에 언론사 기사만 썼습니다. 그러자 Google News 에만 올라온 화제 기사가 카드에서 빠졌고, 그 뒤로 두 풀 모두 합치는 방식이 됐습니다.
4. FinBERT 는 번역 전에 돈다
적용 화면 — 번역은 미디어 탭 › 뉴스의 미국 탭 기사 카드 제목에 적용됩니다. 감성 집계(sentiment_summary)는 브리핑 캐시에만 저장되고, 지금은 이 값을 띄우는 화면이 없습니다.
7월 설명의 "FinBERT 감성분석에 공급한다"는 지금도 맞습니다. 다만 넣는 재료는 brief 풀이 아니라 display 풀의 제목이고, 순서가 중요합니다. 미국 탭 카드는 화면에 띄우기 전에 한국어로 번역하는데, FinBERT 는 그 번역 전 영문 원문 제목으로 돌립니다. 번역본으로 돌리면 뉘앙스가 빠지기 때문입니다. 또 LLM 이 모든 provider 에서 실패해도 카드는 RSS 그대로라 계속 뜹니다. 실패한 쪽은 브리핑 문장뿐입니다.
정리
- 화제성(Google News)과 실주소·이미지(언론사 RSS)는 잘하는 일이 달라 같은 기사를 두 순서로 합쳐 두 풀을 만든다.
- 넓은 피드는 받은 뒤 키워드로 자른다. 미국 탭은 미국 단어가 있어야 통과하고, 국내 증시 단어가 있으면 다시 빠진다.
- 감성분석처럼 언어에 민감한 단계는 번역보다 앞에 둔다.
근거: processor/market_brief.py (_RSS_SOURCES, _GNEWS_SOURCES, _fetch_headlines_uncached, _build_brief) · .omm/data-flow/news-src(2026-07-22). 투자 권유가 아닙니다.
오늘의 시장 뉴스를 모아 보는 곳 → dinsightlab.com
Passive
미국 지수 투자자를 위한 금융 데이터 분석 사이트
dinsightlab.com